نشرت شركة Cerebras شرحاً مفصّلاً لكيفية تشغيلها نماذج ذكاء اصطناعي بتريليون معامل على عتادها المصنوع على مستوى الرقاقة، مستخدمة النموذج مفتوح المصدر Kimi K3 كمثال. وفي منشور بتاريخ 22 أكتوبر 2026، قالت الشركة إنها تقسّم نموذجاً حدودياً كبيراً على عدة رقاقات WSE-3T لتقديم نماذج تبلغ عدة تريليونات من المعاملات بسرعة تتراوح بين 1000 و2000+ رمز في الثانية.
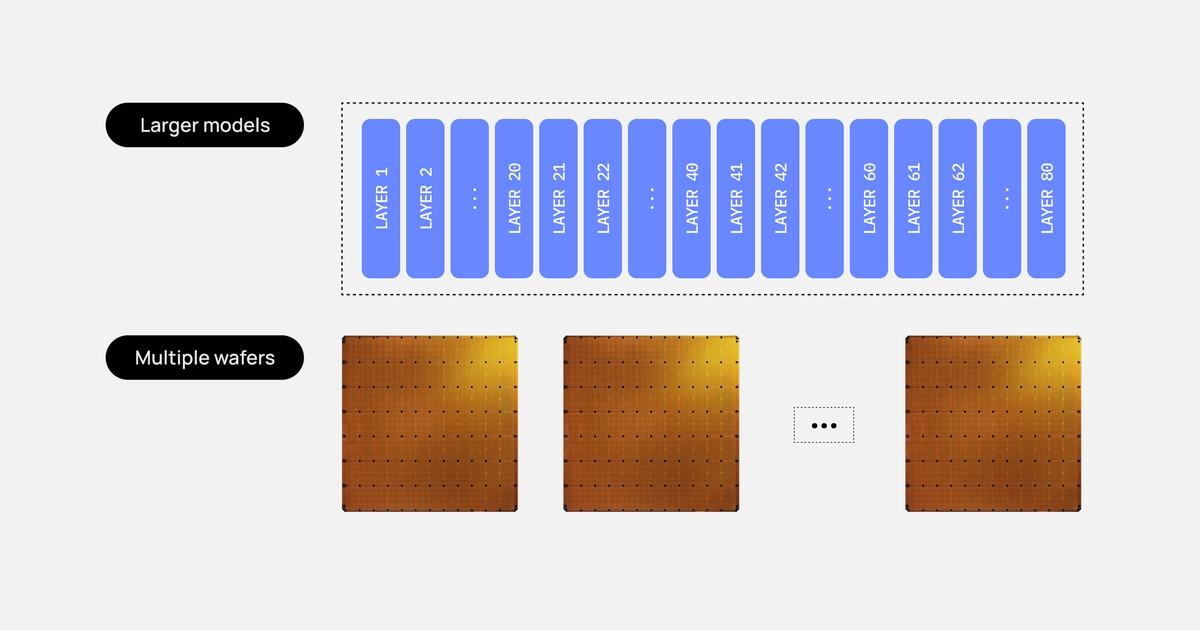
التحدي الهندسي هنا هو الذاكرة: الرقاقة الواحدة من طراز WSE-3T تحمل 44 غيغابايت من الذاكرة المدمجة، بينما تحتاج النماذج بتريليون معامل إلى تيرابايتات لمجرد تخزين أوزانها. وحلّ Cerebras هو توزيع النموذج طبقة تلو الأخرى على عشرات الرقاقات وربطها في خط أنابيب واحد.
كيف توزّع Cerebras نموذج Kimi K3 على 59 رقاقة
Kimi K3 نموذج مفتوح المصدر يضم نحو 3 تريليونات معامل، ويتألف من 69 طبقة انتباه خطي و24 طبقة كثيفة. وبحسب Cerebras، يبلغ حجم المعاملات الخام عند تخزينها بدقة 4 بتات نحو 1.5 تيرابايت موزعة على 93 طبقة، أي ما يعادل نحو 16 غيغابايت لكل طبقة.
ولأن كل رقاقة تملك 44 غيغابايت من ذاكرة SRAM المدمجة، ولأن الطبقة الواحدة تحتاج نحو 16 غيغابايت فقط، فإن معظم الطبقات تتسع بالكامل على رقاقة واحدة. وتقول Cerebras إن هذا يعني أن أوزان النموذج لا تتحرك عموماً، ولا حاجة لتقسيم الطبقات بين الرقاقات، إذ تنتقل التنشيطات فقط بينها.
ويعطي توزيع هذه الطبقات على الرقاقات 35 رقاقة لطبقات الانتباه الخطي و24 رقاقة للطبقات الكثيفة، أي ما مجموعه 59 رقاقة. ثم يوجّه نظام التشغيل الرموز بين الرقاقات، ناقلاً التنشيطات عبر RDMA فوق إيثرنت بزمن يقارب 2 ميكروثانية لكل قفزة.
- Kimi K3: نحو 3 تريليونات معامل، 69 طبقة انتباه خطي و24 طبقة كثيفة
- كل رقاقة WSE-3T: 44 غيغابايت من ذاكرة SRAM المدمجة
- كل طبقة من النموذج: نحو 16 غيغابايت بدقة 4 بتات